


构建端粒到端粒完整基因组,解析复杂基因组区域
一、产品简介
T2T基因组组装
从参考基因组草图到完整染色体解析
传统基因组组装受限于测序读长和准确性,在端粒、着丝粒、高重复序列等复杂区域仍存在大量缺口,导致部分遗传信息无法完整解析。
T2T(Telomere-to-Telomere)基因组组装通过融合 PacBio HiFi 高准确长读长、Nanopore Ultralong Reads 超长读长、Hi-C 染色质互作技术及 RNA-seq 功能注释,实现高连续性、低缺口、染色体级完整基因组构建。
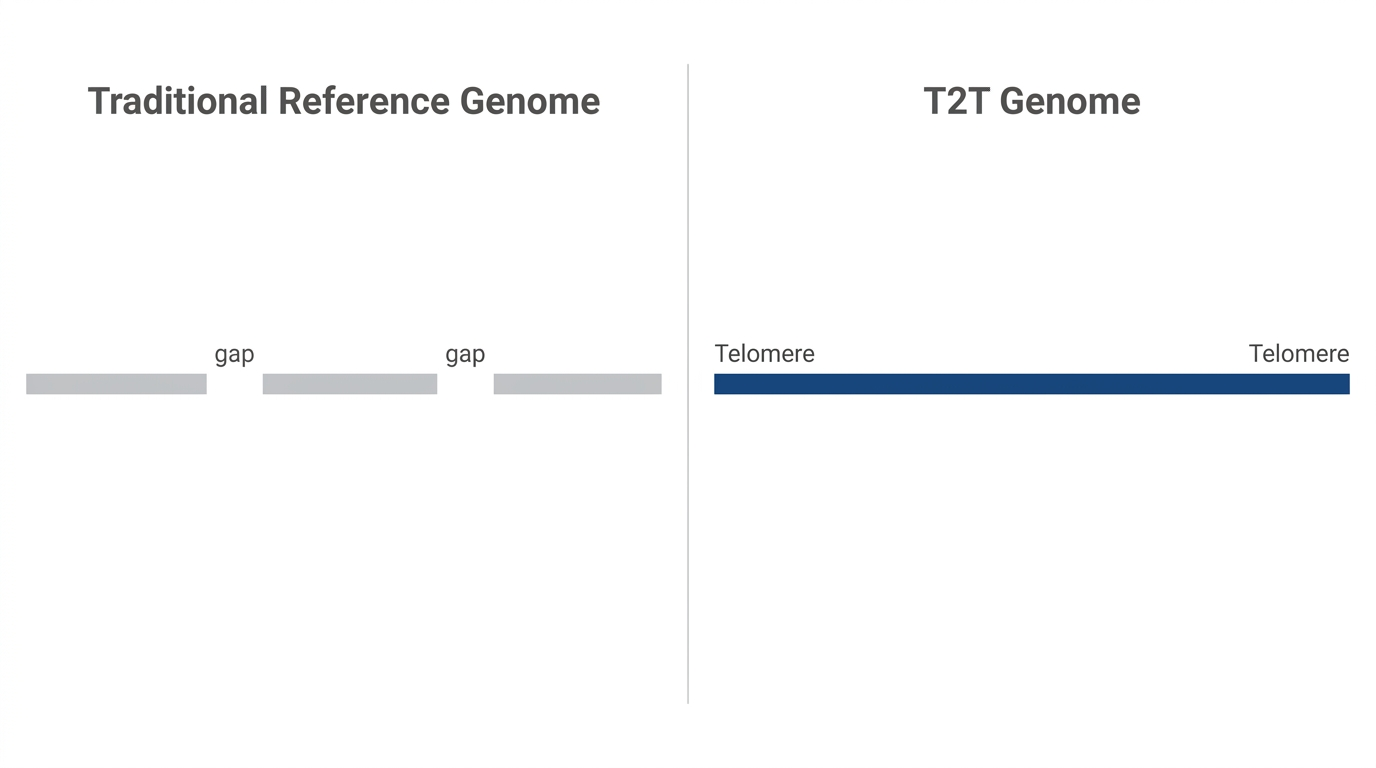
图 1 传统参考基因组 vs T2T 完整基因组对比
──────────────────────────────
二、为什么需要T2T基因组?
传统参考基因组存在三大核心局限:
1. 缺失复杂重复区域
传统技术难以解析的基因组区域包括:
- 端粒(Telomere)
- 着丝粒(Centromere)
- 卫星 DNA(Satellite DNA)
- 长重复序列(Long tandem repeats)

图 2 染色体结构与复杂重复区域
2. 结构变异解析不足
传统组装难以发现的变异类型:
- 大片段插入(Large Insertion)
- 缺失(Deletion)
- 倒位(Inversion)
- 重排(Rearrangement)

图 3 结构变异类型示意
3. 基因结构注释不完整
可能影响的研究方向:
- 新基因发现
- 转录本预测
- 基因功能研究
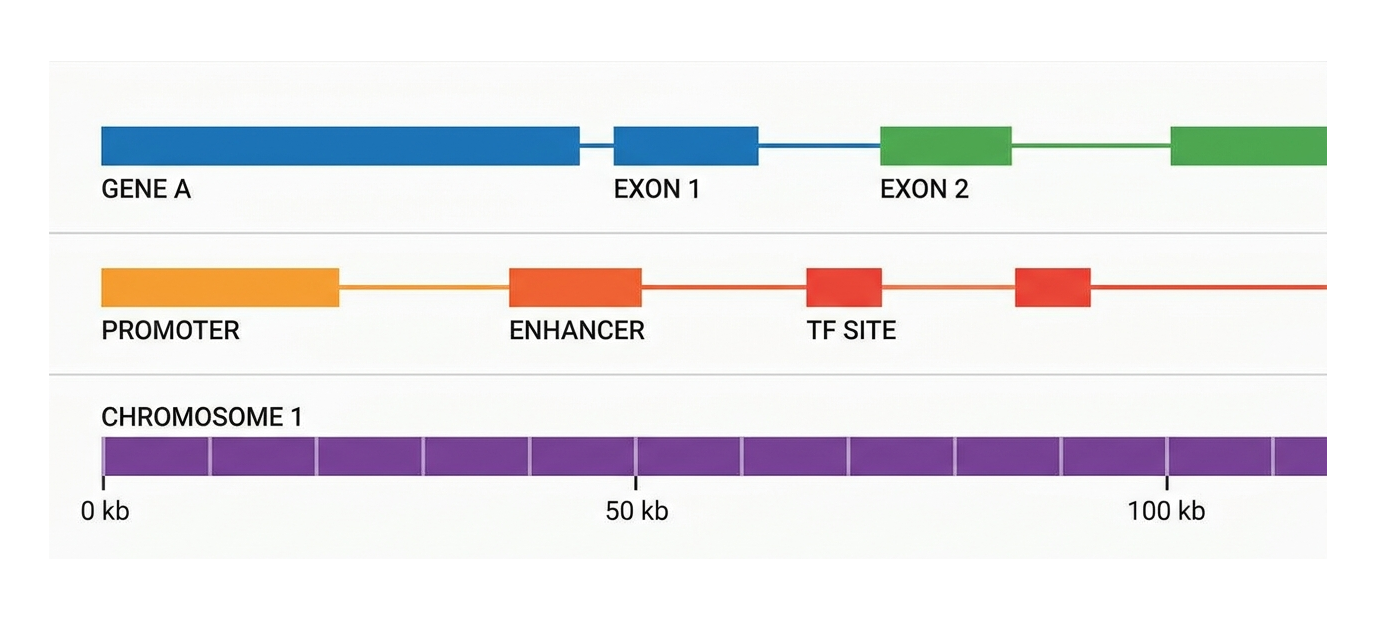
图 4 基因组注释轨道示意
──────────────────────────────
三、T2T基因组组装技术流程
多技术融合,实现完整染色体构建
T2T 组装不是单一技术的胜利,而是 PacBio HiFi、Nanopore Ultralong、Hi-C、RNA-seq 多平台的协同结果。从基因组复杂度评估到完整染色体构建,每一步都为最终质量提供关键支撑。

图 5 T2T 基因组组装整体技术流程
▎Genome Survey — 基因组复杂度评估
通过 K-mer 分析对基因组进行预评估,主要输出:
- 基因组大小(Genome Size)
- 杂合度(Heterozygosity)
- 重复序列比例(Repeat Content)
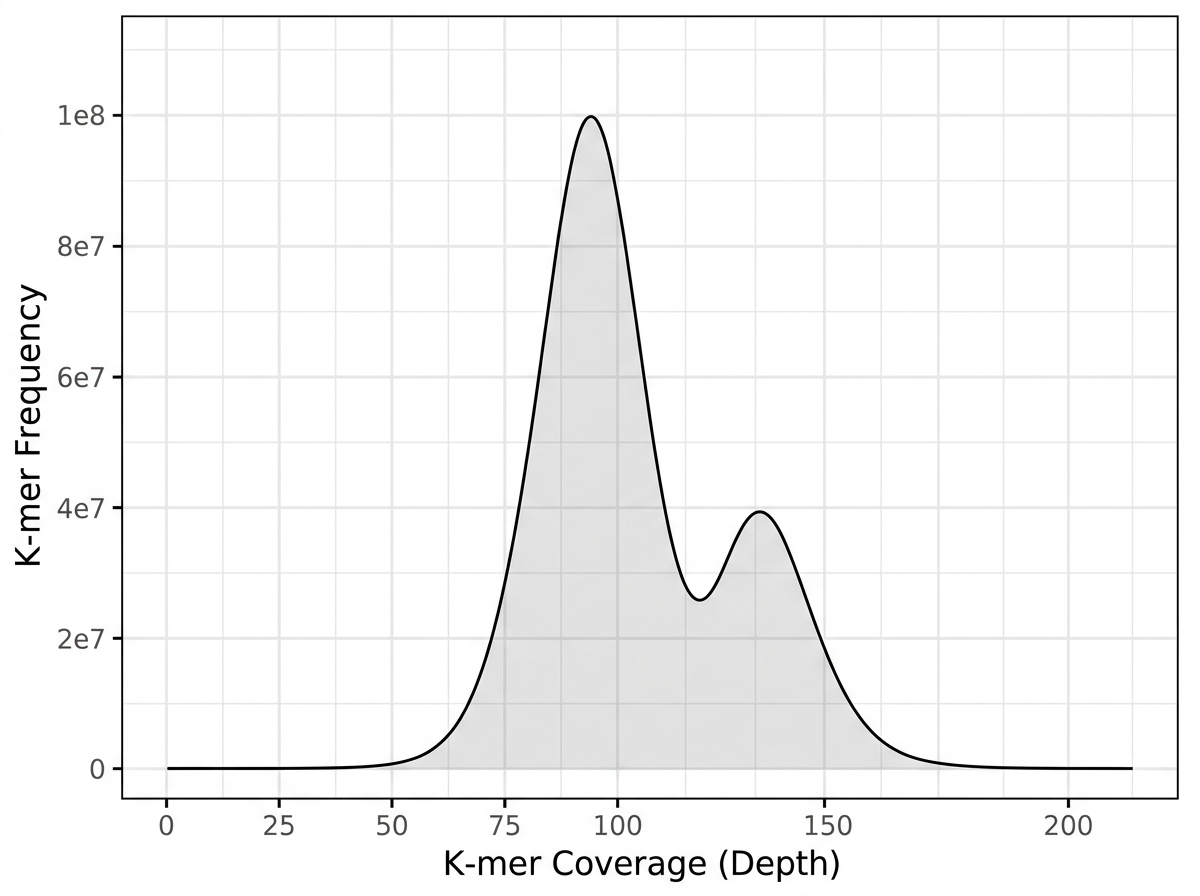
图 6 K-mer 频率分布图
▎PacBio HiFi — 高准确主体组装
提供 15–25 kb 读长、>99.9% 准确率的长读长数据,是 T2T 组装的核心基石:
- 长读长支撑 contig 连续性
- 高准确率保证碱基级精度
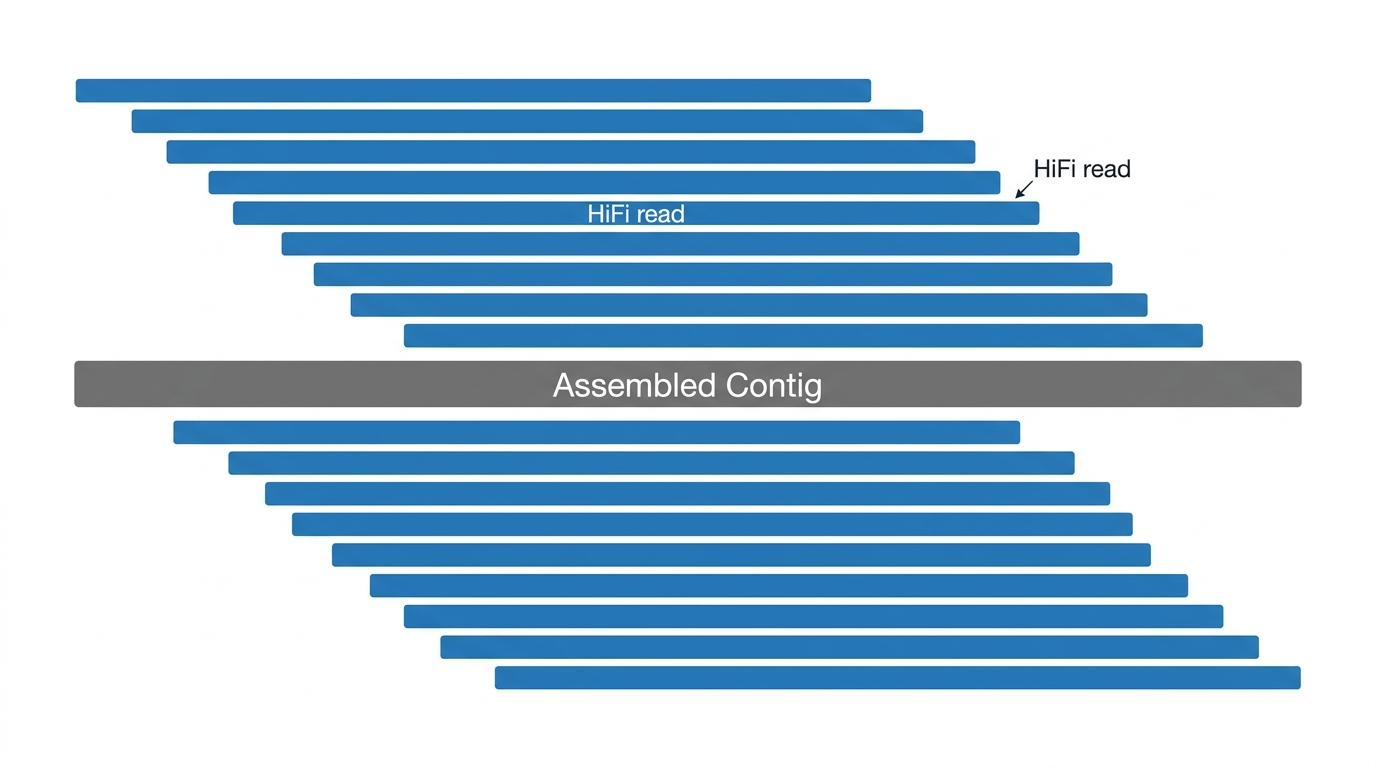
图 7 HiFi reads 覆盖 contig 示意
▎Nanopore Ultralong Reads — 跨越复杂重复区域
提供 100 kb+ 超长读长,跨越传统技术无法解析的复杂区域:
- 单条 read 跨越端粒、着丝粒等 gap 区域
- 直接读通卫星 DNA 等高度重复序列

图 8 Nanopore 超长 read 跨越重复区域
▎Hi-C — 染色体级挂载
通过染色质三维互作信息,将 contig 锚定到染色体级别:
- 辅助 contig 排序与定向
- 验证染色体结构完整性
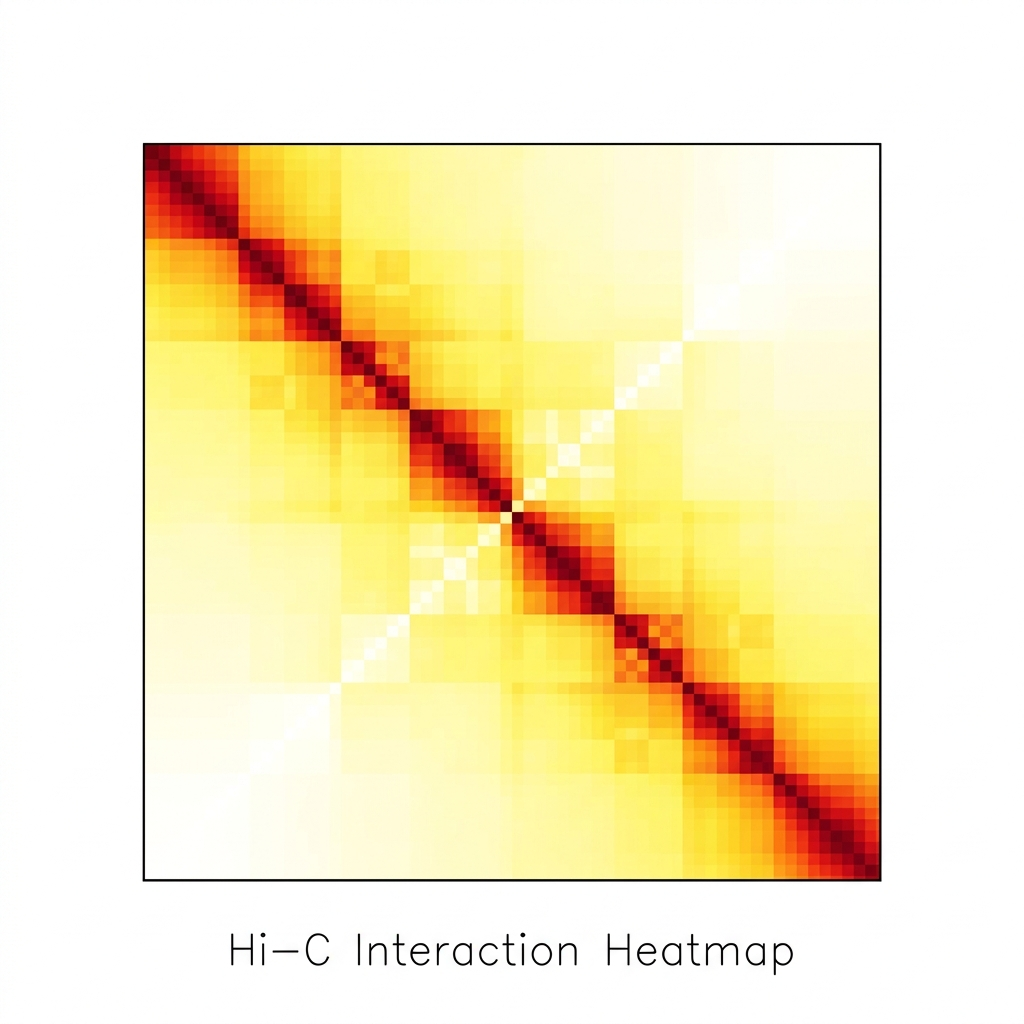
图 9 Hi-C 染色质互作热图
▎RNA-seq — 基因结构与功能注释
提供转录组证据,辅助基因结构注释与功能研究:
- 辅助基因模型预测
- 解析可变剪接
- 支持功能注释
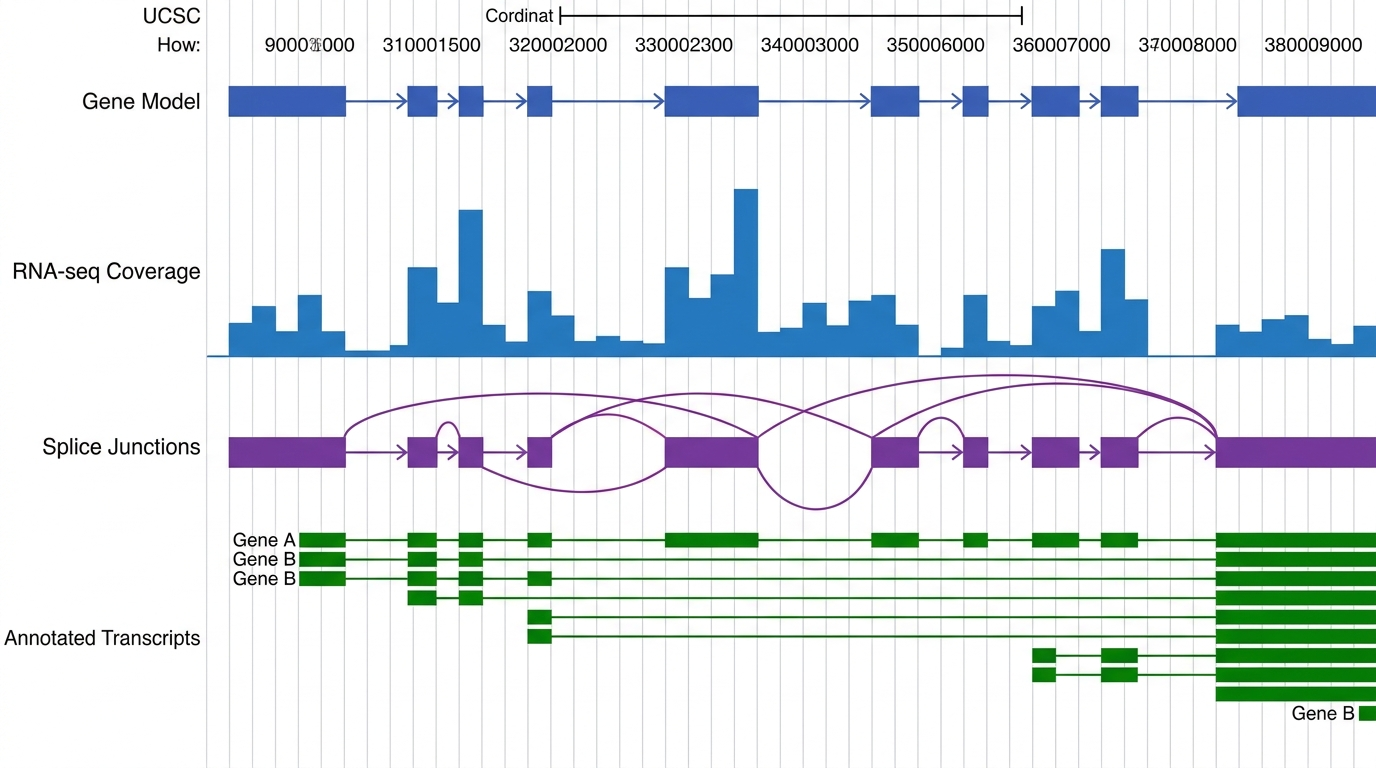
图 10 RNA-seq 辅助的基因组浏览器视图
──────────────────────────────
四、T2T基因组组装技术优势
01 高连续性完整组装
融合 PacBio HiFi 高准确率与 Nanopore Ultralong 超长读长优势,实现低 gap、高连续性基因组组装,contig N50 较传统组装提升数十倍。
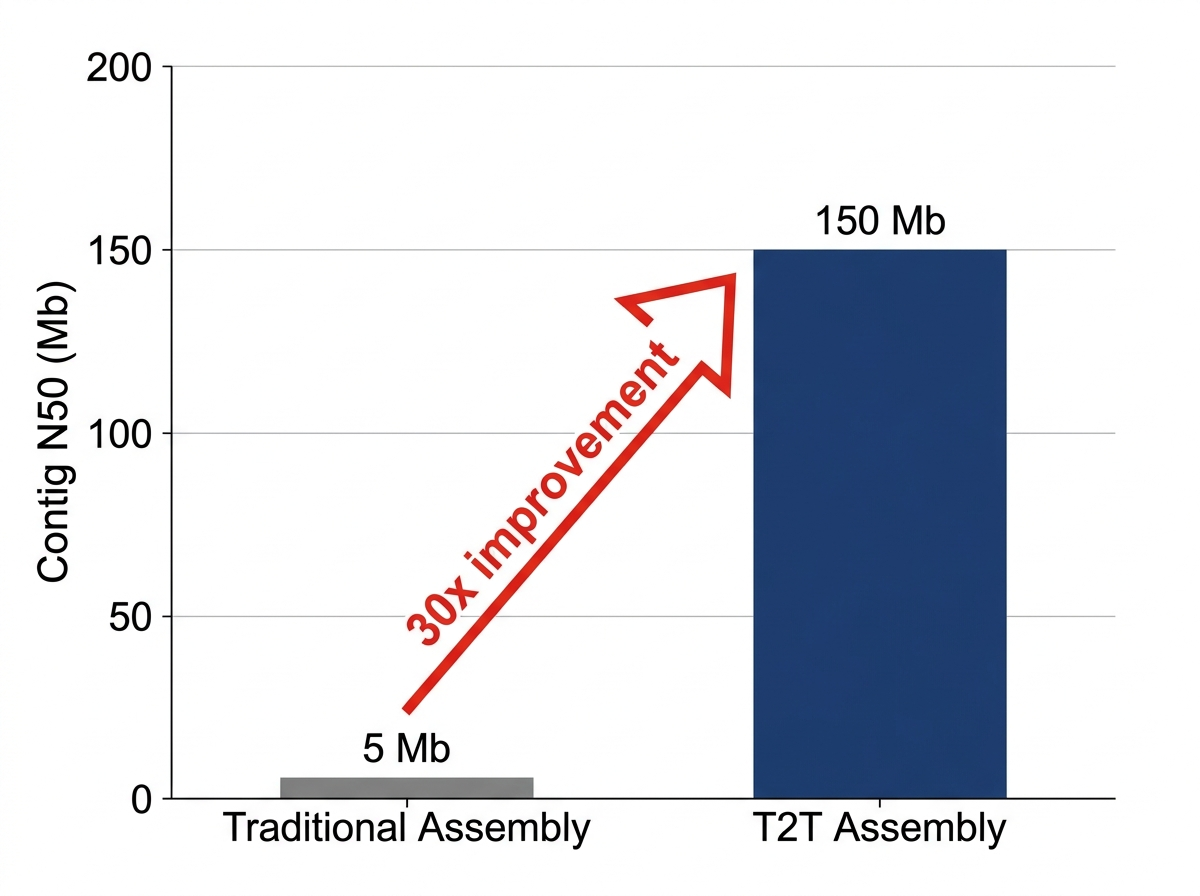
图 11 Contig N50 提升对比示意
02 复杂区域精准解析
突破传统组装在以下区域的解析限制:
- 端粒(Telomere)
- 着丝粒(Centromere)
- 高重复序列(High-repeat regions)
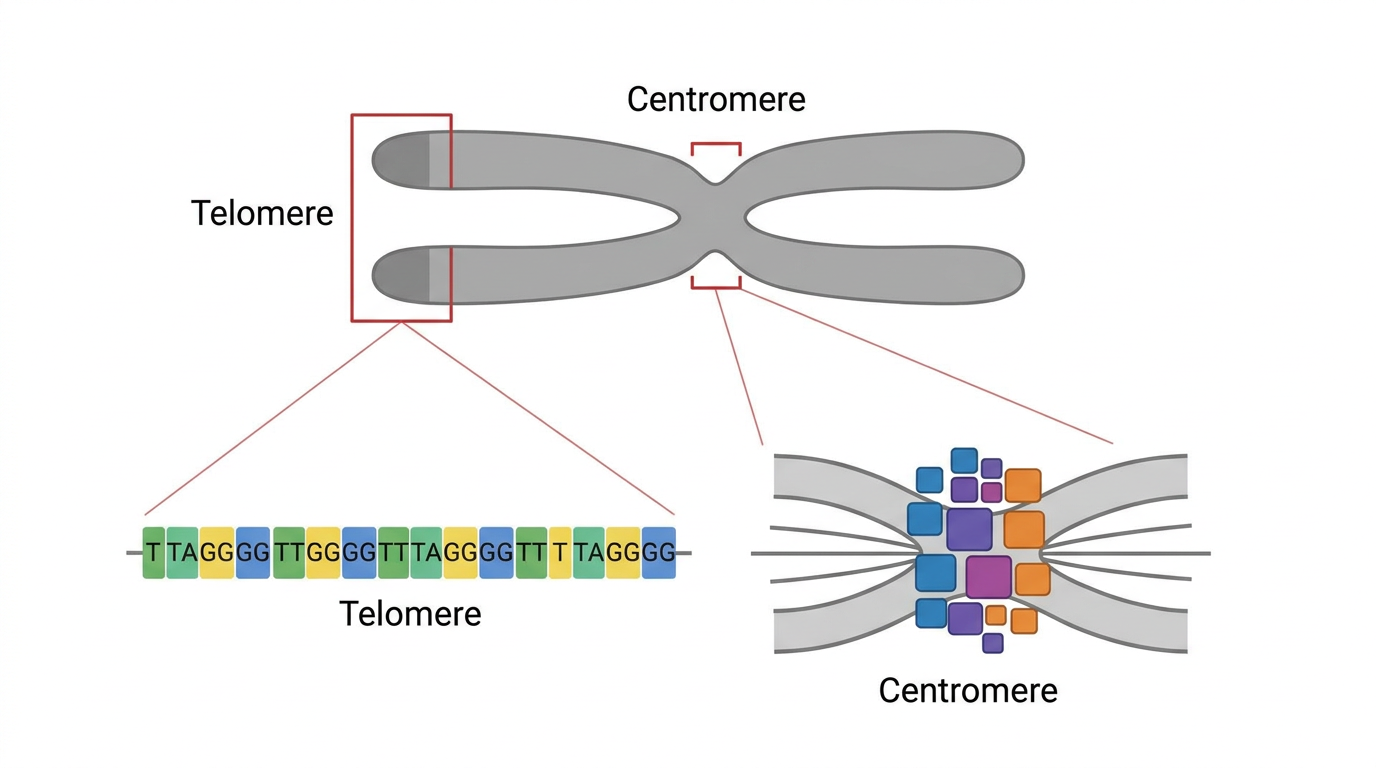
图 12 端粒与着丝粒区域放大示意
03 染色体级基因组构建
结合 Hi-C 染色质互作信息,实现 contig 到染色体的精准挂载,输出真正意义上的染色体级别基因组。
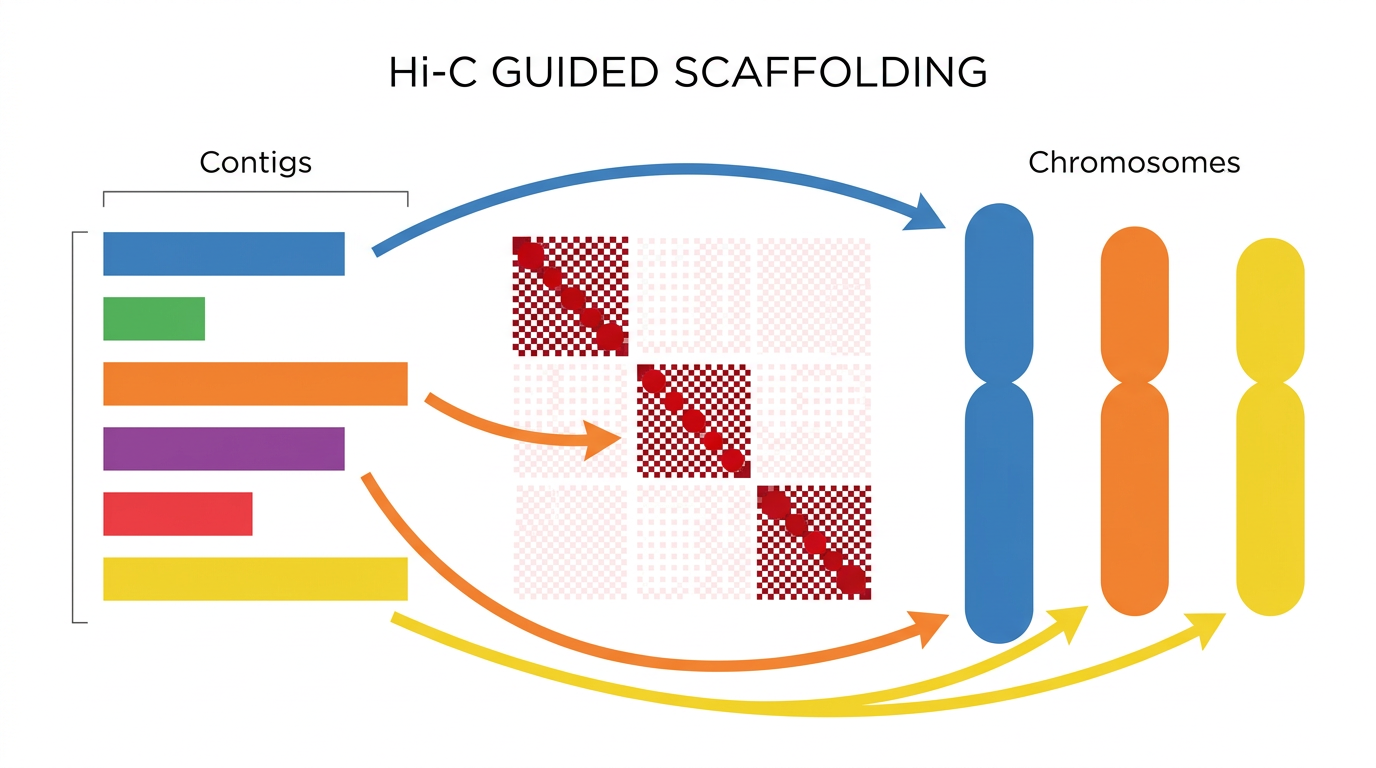
图 13 Hi-C 辅助 contig 到染色体挂载
04 多组学辅助功能注释
整合 RNA-seq 转录组证据,提升基因预测准确性与功能注释质量,为下游研究提供高价值基因组资源。
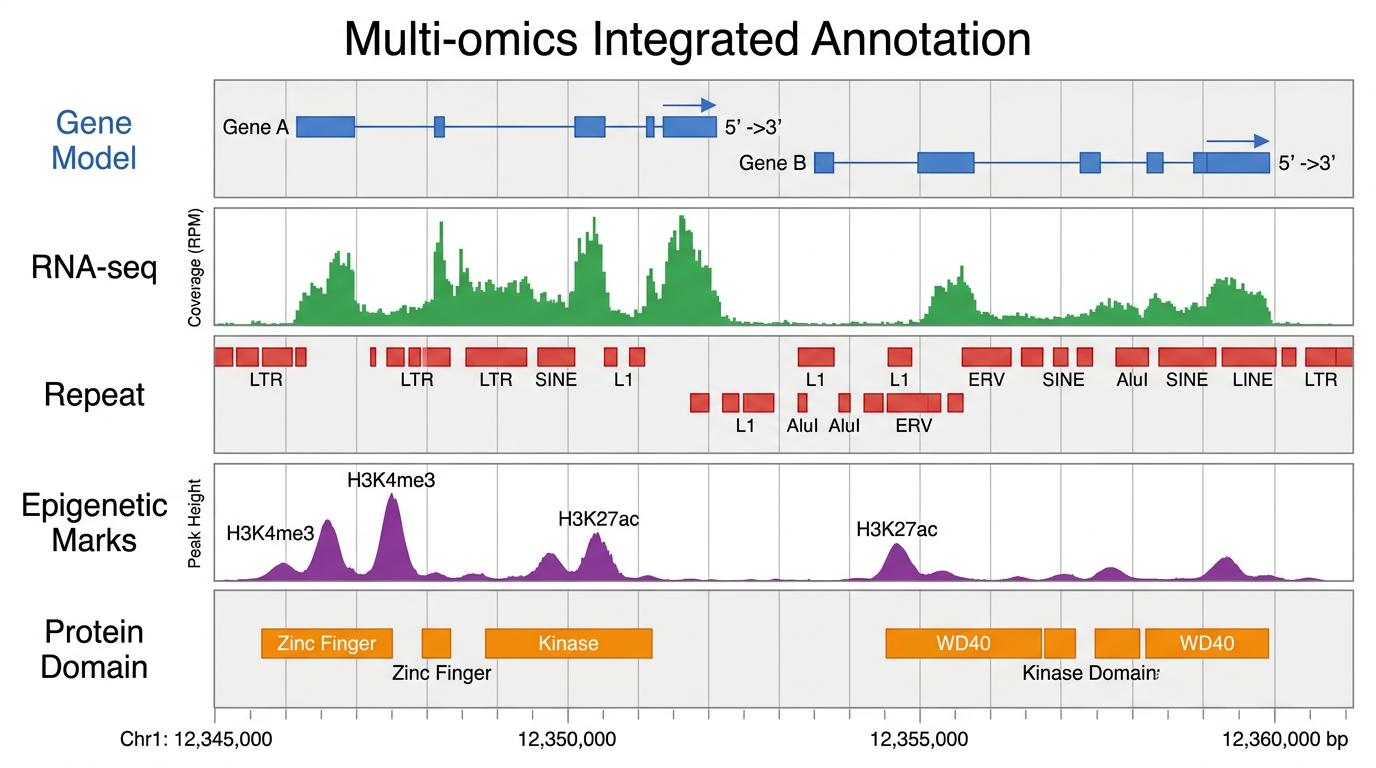
图 14 多组学辅助基因功能注释
──────────────────────────────
五、T2T组装结果展示
高质量 T2T 基因组组装结果
A. Genome Survey
通过 K-mer 分析评估基因组基本特征:
- 基因组大小评估
- 杂合度估计
- 重复序列比例
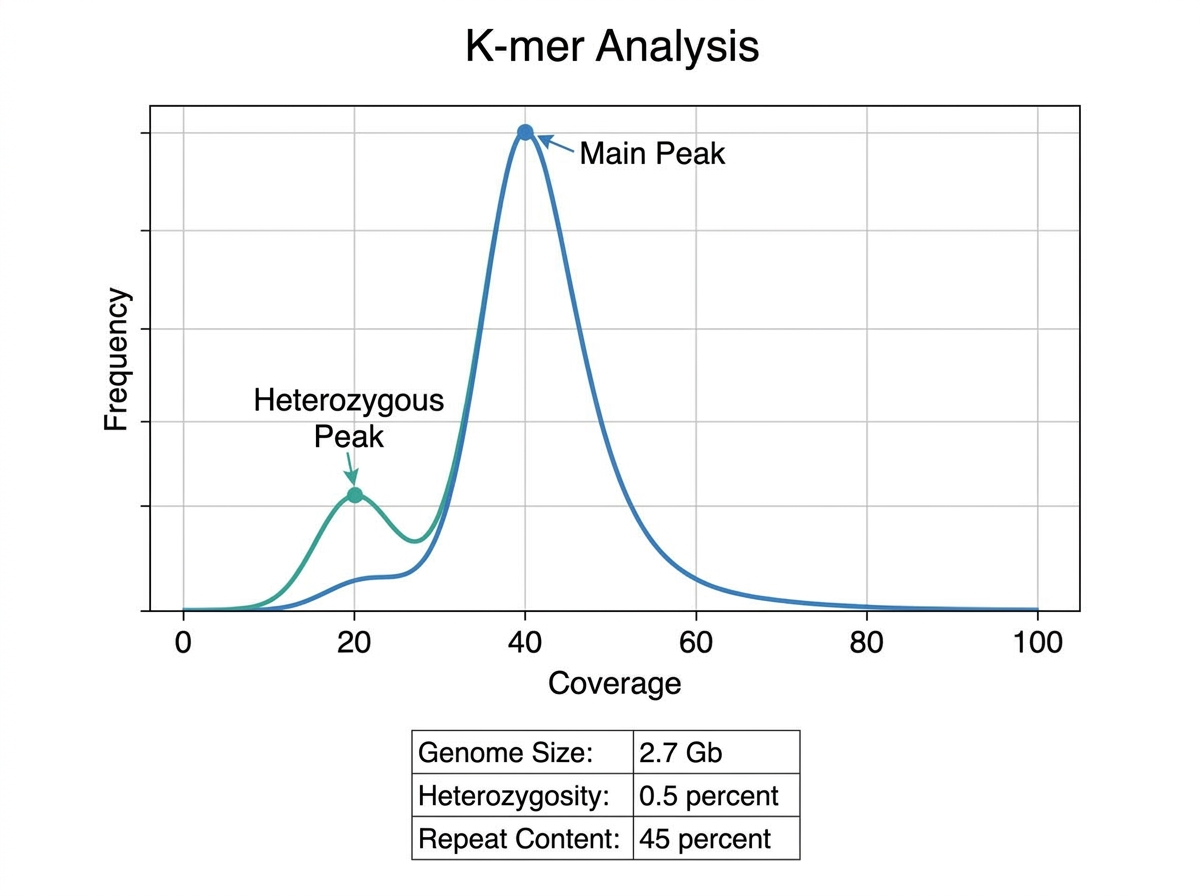
图 A K-mer 分析结果示例
B. T2T 染色体完整组装
Telomere-to-Telomere 完整染色体核型展示:
- 端粒到端粒(Telomere-to-Telomere)
- 0 gap 完整覆盖
- 包含端粒与着丝粒全结构
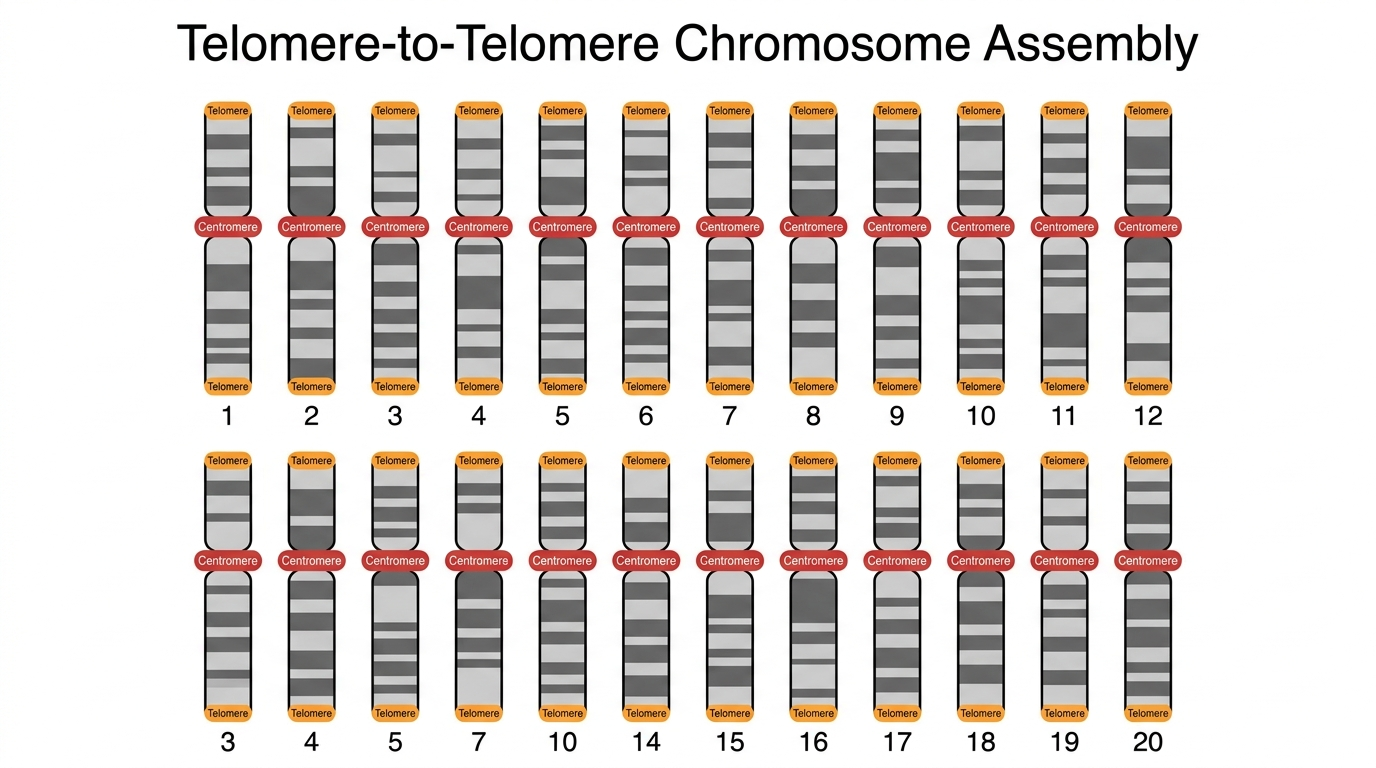
图 B T2T 完整染色体核型图
C. Hi-C 染色体互作验证
通过 Hi-C 互作热图验证组装质量:
- 验证染色体结构正确性
- 确认 contig 连续性
- 支撑染色体级挂载
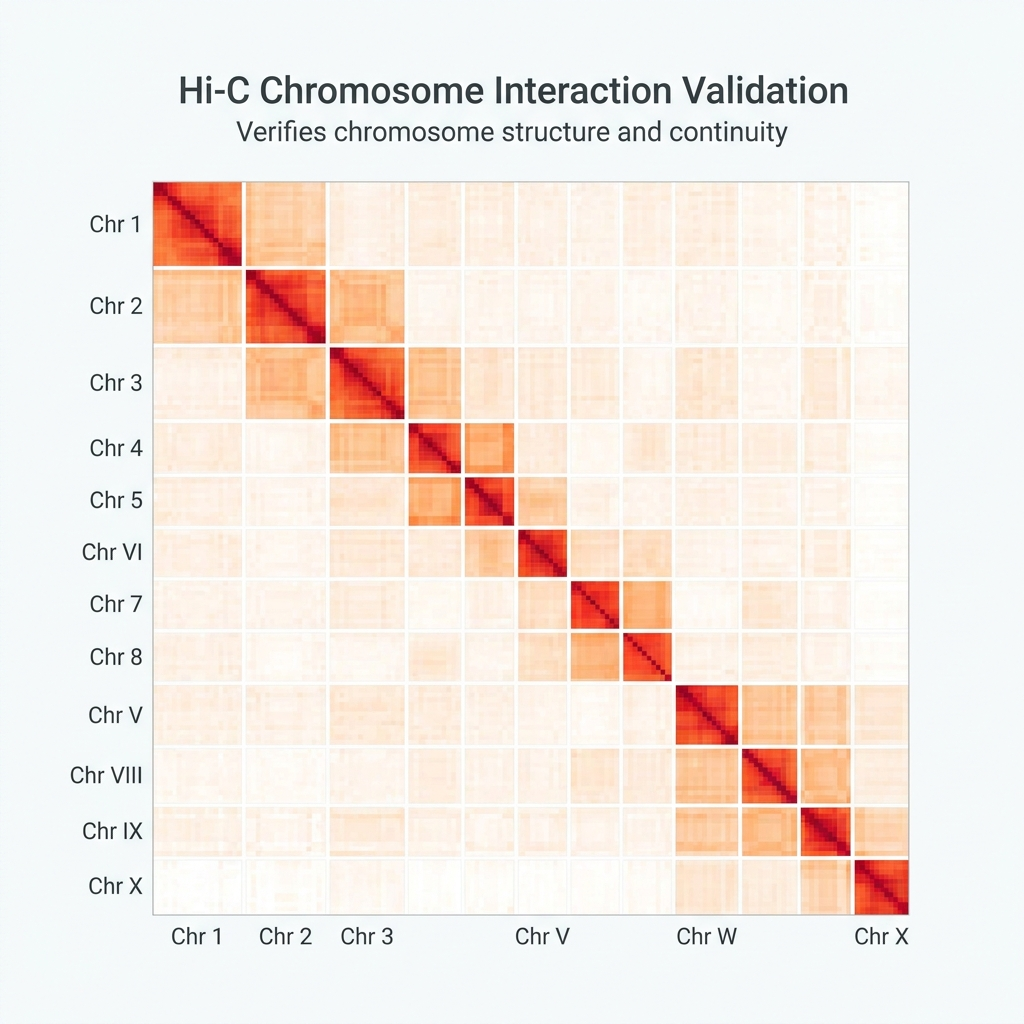
图 C 全基因组 Hi-C 互作热图
D. Circos 综合分析
整合多维度基因组信息的 Circos 全景展示:
- 基因注释
- 结构变异(SV)
- 重复序列分布
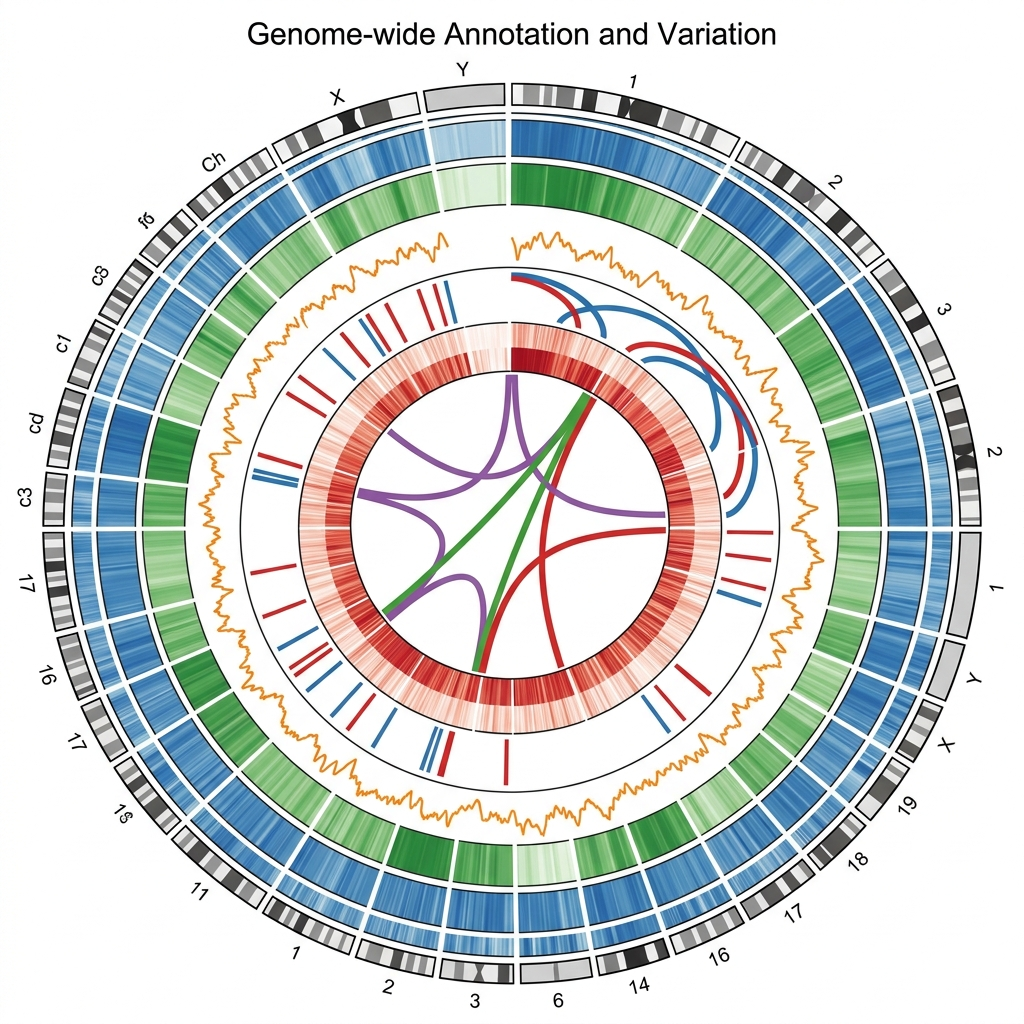
图 D Circos 基因组注释与变异全景图
──────────────────────────────
六、应用案例
案例:C57BL/6J 与 CAST/EiJ 小鼠 T2T 基因组组装
作者采用PacBio HiFi测序(188×覆盖度)与Oxford Nanopore超长读长测序(70×覆盖度,其中约22×读长超过100 kb)相结合的策略,成功完成了两个关键近交系小鼠亚种——C57BL/6J与CAST/EiJ——的首个端粒到端粒(T2T)完整基因组组装。超长读长测序,特别是Nanopore技术提供的超长片段,有效跨越了高度重复的端粒与着丝粒区域。最终组装较现有参考基因组新增约213 Mb序列,其中包含517个蛋白编码基因,新序列主要由卫星DNA等重复元件构成(图A)。着丝粒区域在两个亚种间呈现出显著的大小差异与结构多样性(图B)。同时,填补了GRCm39中绝大多数序列间隙(图C),并完整解析了KRAB锌指蛋白基因簇的结构(图D)。这些T2T组装为深入理解小鼠基因组结构变异提供了高质量基础资源。
案例图示:

图 19-A

图 19-B
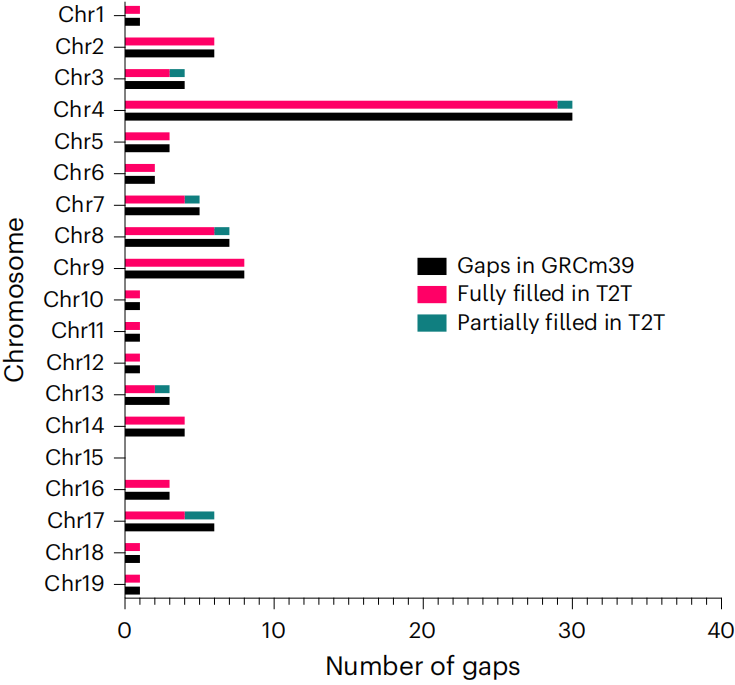
图 19-C
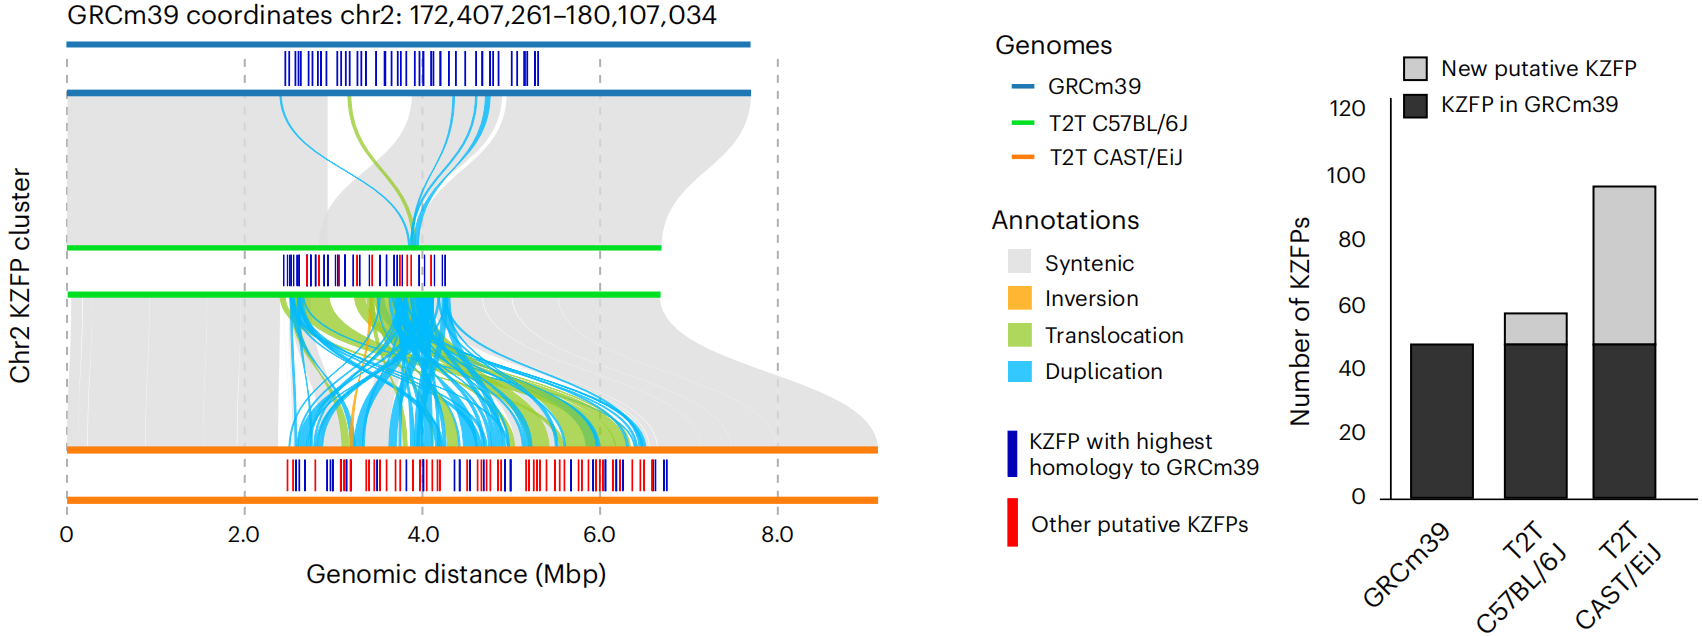
图 19-D
参考文献:
Francis, B.A., Gozashti, L., Costello, K. et al. Complete genome assemblies of two mouse subspecies reveal structural diversity of telomeres and centromeres. Nat Genet 57, 2852–2862 (2025).
──────────────────────────────
七、推荐测序方案
T2T 基因组组装推荐数据量(以 2–3 Gb 基因组为参考)
| 模块 | 测序平台 | 推荐数据量 | 作用 |
| 基因组 Survey | NGS PE150 | 30–50× | 评估基因组大小、杂合度、重复比例 |
| 主体组装 | PacBio HiFi | 30× | 提供高准确长读长,构建 contig |
| 复杂区域解析 | Nanopore Ultralong | 20–30× | 跨越端粒、着丝粒等复杂区域 |
| 染色体挂载 | Hi-C | 100× | contig 锚定到染色体 |
| 功能注释 | RNA-seq | 2–3× | 辅助基因结构与功能注释 |
※ 实际推荐数据量根据样本基因组大小、复杂度、研究目的调整;项目周期根据多组学组合情况确定。
──────────────────────────────
八、应用方向
T2T 基因组组装技术适用于:
 |
 |
 |
| 动物 | 植物 | 微生物 |
▎非模式物种基因组资源构建
为缺乏高质量参考基因组的物种构建端粒到端粒级别参考序列,推动该物种从「有参考」走向「高质量参考」。
▎重要动植物育种研究
精准解析农艺性状相关基因完整结构,挖掘关键变异位点,为分子育种提供高质量基因组基础。
▎复杂性状遗传解析
完整揭示复杂遗传区域的结构变异与基因结构,支撑复杂性状的遗传基础研究。
▎进化与比较基因组研究
通过端粒到端粒级别的比较基因组分析,解析物种间基因组结构差异与演化轨迹。
单倍型T2T(Haplotype-resolved T2T)基因组组装


